- octubre 7, 2026
- 0 Comments
- By Elena

Javier López
Introducción
Los sistemas críticos requieren arquitecturas capaces de mantener disponibilidad, trazabilidad y capacidad de recuperación incluso ante fallos parciales o picos de demanda. En este contexto, patrones como CQRS y Event Sourcing permiten desacoplar operaciones, mejorar la escalabilidad y registrar de forma precisa los cambios producidos en una aplicación.
Sin embargo, su adopción también transforma la operación técnica. Una incidencia puede involucrar comandos, eventos, colas, consumidores, proyecciones de datos y servicios distribuidos, lo que exige nuevas capacidades de monitorización, diagnóstico y recuperación.
Para los equipos de soporte de aplicaciones, operaciones, DevOps y SRE, comprender estos modelos es esencial para garantizar estabilidad, resiliencia y continuidad del servicio.
CQRS: separación entre operaciones de lectura y escritura
CQRS es un patrón arquitectónico que separa las acciones que modifican el estado de un sistema de aquellas que únicamente consultan información.
Las operaciones de escritura, o commands, representan acciones como crear un pedido, aprobar una transacción o actualizar los datos de un cliente. Las operaciones de lectura, o queries, permiten consultar ese estado sin alterarlo, por ejemplo para mostrar un pedido, generar un informe o alimentar una interfaz de usuario.
A diferencia de una arquitectura tradicional, CQRS permite que los modelos de lectura y escritura se diseñen de forma independiente. El modelo de escritura puede centrarse en validar reglas de negocio y garantizar la consistencia de la operación, mientras que el modelo de lectura puede optimizarse para responder con rapidez a un gran volumen de consultas.
Este enfoque aporta mayor escalabilidad, flexibilidad y capacidad para evolucionar componentes sin afectar al conjunto del sistema.
No obstante, también introduce un aspecto relevante para soporte y operaciones: la consistencia eventual. Tras ejecutar una operación, puede existir un breve intervalo antes de que el cambio aparezca reflejado en todos los modelos de lectura. Por ello, los equipos técnicos deben diferenciar entre una latencia esperada y un fallo real en la propagación o procesamiento de eventos.
Event Sourcing: reconstruir el estado a partir de eventos
Event Sourcing es un patrón de persistencia en el que el sistema registra los cambios de estado como una secuencia de eventos. En lugar de guardar únicamente el valor final de una entidad, conserva el historial de acciones que han dado lugar a ese estado.
Por ejemplo, en un sistema financiero no se almacenaría exclusivamente el saldo actual de una cuenta. El sistema podría registrar eventos como “cuenta creada”, “ingreso realizado”, “cargo aplicado”, “transferencia emitida” o “operación anulada”. El saldo actual se obtendría a partir de la secuencia de eventos registrada.
Cada evento representa un hecho ocurrido en el sistema. Normalmente, estos eventos son inmutables: una vez almacenados, no se modifican. Cuando es necesario corregir una operación, se genera un nuevo evento que compensa, ajusta o invalida el efecto anterior, manteniendo la trazabilidad completa del proceso.
Esta característica aporta un valor significativo en sistemas críticos:
- Historial detallado y verificable de operaciones.
- Mayor capacidad de auditoría.
- Reconstrucción del estado de una entidad o proceso.
- Mejor análisis de incidencias y comportamiento operativo.
- Posibilidad de reprocesar eventos para regenerar proyecciones o datos derivados.
- Mayor visibilidad sobre cambios, decisiones y dependencias dentro de un flujo.
En entornos con un volumen elevado de eventos, reconstruir el estado completo desde el origen puede resultar costoso. Por ello, algunas arquitecturas utilizan snapshots, es decir, puntos de estado intermedio que permiten acelerar la recuperación sin eliminar el historial de eventos.
Desde la perspectiva de operación, Event Sourcing exige una gestión madura del ciclo de vida de los eventos. Deben publicarse, almacenarse, procesarse, consumirse y reflejarse en los modelos correspondientes de forma controlada y observable.
CQRS y Event Sourcing: patrones complementarios, no obligatorios
CQRS y Event Sourcing son patrones independientes, aunque suelen combinarse en arquitecturas basadas en eventos.
CQRS separa las responsabilidades entre escritura y lectura. Event Sourcing registra los cambios generados por las operaciones de escritura como eventos. Estos eventos pueden alimentar distintos modelos de lectura o proyecciones: paneles operativos, interfaces de usuario, informes, servicios de analítica, integraciones con terceros o sistemas de notificación.
La combinación permite construir sistemas con un alto nivel de desacoplamiento. Una misma operación puede generar eventos que sean consumidos por varios servicios sin que todos dependan directamente entre sí. Esto facilita la escalabilidad y la evolución de funcionalidades, pero incrementa la complejidad operativa.
Para el soporte IT, la principal consecuencia es que el estado de una operación ya no se encuentra necesariamente en un único punto. Puede ser necesario revisar el comando inicial, el evento generado, el estado de una cola, el consumidor responsable, la proyección de lectura y la respuesta de otros servicios dependientes.
La estabilidad de la plataforma depende, por tanto, de la correcta coordinación entre componentes distribuidos.
Qué cambia para el soporte IT en sistemas críticos
En arquitecturas tradicionales, la investigación de una incidencia suele centrarse en identificar una aplicación afectada, revisar sus registros y validar el estado de los datos en una base de datos.
En entornos CQRS y Event Sourcing, el diagnóstico debe ser más amplio. Una incidencia visible para el usuario puede tener su origen en una parte diferente del flujo: un evento no publicado, un consumidor detenido, una cola saturada, una proyección desactualizada, un problema de conectividad o una dependencia externa que no ha respondido correctamente.
El soporte de aplicaciones debe disponer de visibilidad sobre el recorrido completo de una operación. Esto implica poder responder a preguntas como las siguientes:
- ¿El comando inicial fue recibido y validado?
- ¿Se generó el evento asociado a la operación?
- ¿El evento se publicó correctamente en el sistema de mensajería?
- ¿Los consumidores procesaron el evento dentro del tiempo esperado?
- ¿La proyección de lectura se actualizó de forma correcta?
- ¿Existe un error de deserialización, incompatibilidad de esquema o fallo de dependencia?
- ¿La operación requiere un reprocesamiento, un evento compensatorio o una corrección de proyección?
La respuesta a estas preguntas requiere una combinación de conocimiento arquitectónico, observabilidad y procedimientos operativos definidos.
También es fundamental comprender el comportamiento de la consistencia eventual. El soporte no debe interpretar como una incidencia cualquier diferencia temporal entre el sistema de escritura y el modelo de lectura. Sin embargo, sí debe disponer de umbrales para identificar cuándo esa demora supera los niveles aceptables y puede afectar a procesos críticos o a la experiencia de usuario.
Tabla comparativa: arquitectura tradicional frente a CQRS y Event Sourcing
Característica |
Arquitectura tradicional |
CQRS + Event Sourcing |
|---|---|---|
Persistencia principal |
Estado actual de la entidad |
Secuencia de eventos y proyecciones |
Modelo de lectura y escritura |
Compartido habitualmente |
Separado y optimizado por función |
Escalabilidad |
Más condicionada por el diseño centralizado |
Mayor desacoplamiento y escalabilidad selectiva |
Trazabilidad |
Dependiente de logs y auditoría adicional |
Historial completo de cambios |
Consistencia |
Habitualmente inmediata |
Puede incluir consistencia eventual |
Diagnóstico |
Aplicación, infraestructura y base de datos |
Eventos, trazas, consumidores y dependencias |
Recuperación |
Restauración de datos o servicios |
Reprocesamiento, reconstrucción o eventos compensatorios |
Complejidad operativa |
Menor en entornos simples |
Mayor, especialmente en observabilidad |
Gestión de incidencias en arquitecturas basadas en eventos
La gestión de incidencias debe adaptarse para evitar correcciones superficiales. Reiniciar un servicio o modificar manualmente un registro puede ocultar el síntoma, pero no resolver el origen del fallo dentro del flujo de eventos.
Ante una incidencia, el equipo debe identificar primero la operación afectada mediante un identificador de correlación, una referencia de pedido, una transacción o un evento concreto. A partir de ese punto, debe verificar el recorrido de la operación por los diferentes componentes.
Un procedimiento eficaz suele incluir la validación del comando inicial, la comprobación de que el evento ha sido generado y publicado, la revisión de consumidores, el análisis de errores y reintentos, y la confirmación de que las proyecciones se han actualizado correctamente.
La acción correctiva dependerá de la causa raíz. En algunos casos será necesario reprocesar eventos de forma controlada. En otros, corregir una proyección de lectura, resolver un bloqueo en la mensajería, recuperar un servicio dependiente o generar un evento compensatorio que ajuste una operación anterior.
Este enfoque evita intervenciones manuales que pueden comprometer la integridad del historial, generar inconsistencias adicionales o dificultar la auditoría posterior.
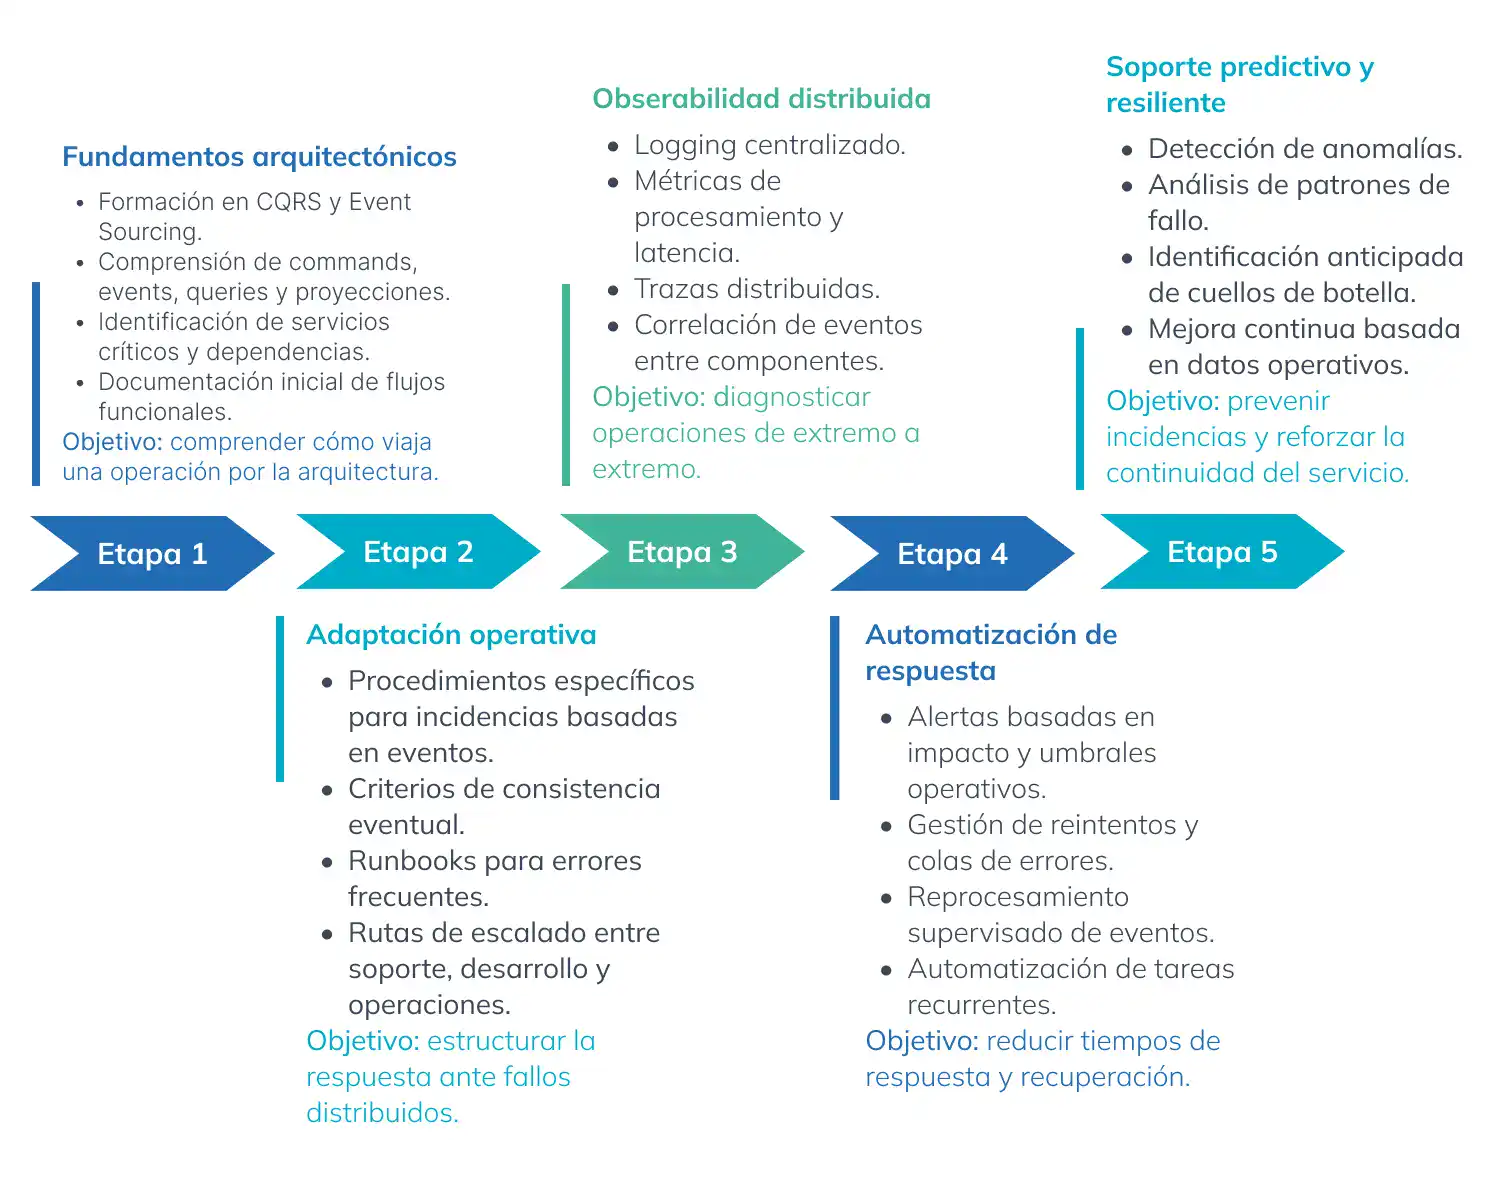
Madurez del soporte IT en arquitecturas CQRS y Event Sourcing
Herramientas y prácticas necesarias para una operación estable
La operación de sistemas CQRS y Event Sourcing requiere herramientas capaces de correlacionar información de múltiples fuentes. Los logs centralizados permiten revisar errores y comportamientos de los servicios. Las trazas distribuidas ayudan a seguir una transacción a través de diferentes componentes. Las métricas operativas aportan visibilidad sobre tiempos de procesamiento, volumen de eventos, errores, reintentos o acumulación de mensajes pendientes.
Los dashboards deben facilitar una visión comprensible del estado de los servicios críticos. Deben permitir identificar si una incidencia afecta a una capacidad de negocio concreta, como el procesamiento de pedidos, pagos, reservas, altas de clientes o gestión de inventario.
Además de las herramientas, son necesarias prácticas operativas consistentes:
- Documentar los flujos de eventos y las dependencias relevantes.
- Definir identificadores de correlación para seguir transacciones completas.
- Establecer criterios de alerta vinculados al impacto de negocio.
- Diseñar mecanismos seguros de reintento y reprocesamiento.
- Mantener procedimientos para gestionar eventos fallidos y proyecciones desactualizadas.
- Revisar la capacidad de colas, consumidores y servicios dependientes.
- Integrar desarrollo, operaciones y seguridad mediante prácticas DevOps y SRE.
- Formar a los equipos de soporte avanzado en sistemas distribuidos y observabilidad.
La calidad de la operación depende tanto de la arquitectura como de la capacidad del equipo para interpretar la información disponible y aplicar correcciones de forma controlada.
Retos y tendencias en la operación de sistemas basados en eventos
La principal dificultad de CQRS y Event Sourcing es la complejidad distribuida. La separación de responsabilidades mejora la capacidad de escalado y reduce dependencias directas, pero también incrementa el número de elementos que deben observarse y gestionarse.
La falta de trazabilidad puede provocar diagnósticos lentos, escalados innecesarios y dificultad para identificar el origen de una incidencia. Por este motivo, la observabilidad no debe considerarse un complemento posterior al desarrollo, sino una capacidad necesaria desde el diseño de la arquitectura.
La automatización también adquiere un papel relevante. Los mecanismos de reintento, la gestión de mensajes fallidos, la detección de anomalías y la correlación de alertas pueden reducir la carga operativa y acelerar la recuperación. Sin embargo, la automatización debe aplicarse con controles adecuados para evitar reprocesamientos incorrectos o efectos no deseados sobre datos críticos.
A medida que estas arquitecturas se integran con servicios cloud, plataformas serverless y entornos híbridos, también aumenta la necesidad de incorporar seguridad, control de accesos, gestión de secretos y supervisión de integraciones como parte del modelo operativo.